PROACTIVE AGENT EVOLUTION
Agentが先に発見し、
自分のやり方で進化する。
Agentic Shapingとは、AI Agentが会話や作業の中にある暗黙知・好み・失敗・データを待つことなく発見し、ルール・記憶・スキーマ・テンプレート・検証器・ツールへと形にし、次の実行で自ら先に適用する仕事術です。
5分で適用するコーディングだけではありません。ドキュメント・分析・画像・動画・デプロイまで同じ方法で機能します。
自ら発見し、構造化する ↓
最初の実行速く正確な進化
01 · WHY
良い結果が得られたのに、
なぜ次はまた最初から説明するのでしょうか?
AIと仕事をしていると、かなり良い結果が出ることがあります。しかし会話が終わると、なぜその選択を好んだのか、どんな失敗を嫌ったのか、何を完了とみなすのかまで一緒に消えてしまいがちでした。
そこで考え方を変えました。Agentに結果だけを作らせるのではなく、 作業の中から私を発見し、次の作業の進め方まで自ら変えさせよう。 これがAgentic Shapingの出発点です。
PASSIVE AGENT依頼 → 結果 → 忘却
→
SHAPING AGENT検知 → 構造化 → 適用 → 進化
02 · START IN 5 MINUTES
説明はここまでです。
このプロンプトをまず貼り付けてください。
プロジェクトの指示に入れると最もよく機能します。まずは1回の会話で試しても構いません。
AGENTIC SHAPING · STARTER PROMPT
Agentic Shaping v0.6

この作業には Agentic Shaping を適用してください。

説明や提案だけで終わらせず、現在の依頼を完了させる行動は必ず実行し、再利用価値が確認されたシグナルがある場合は、次回の実行を改善する行動も併せて実行してください。複数の段階が必要な場合は、都合のよい一部だけを選ばず、完了に必要な全体の経路を実行してください。

作業を計画したり行動を選択したりする際は、①現在の依頼の成果を実際に完成させる行動、②機密情報・権限・形式などの安全境界を守る行動、③再利用価値が確認された場合にのみ次回の実行を改善する行動を、それぞれ独立して確認し、該当する行動をすべて明示的に実行してください。いずれかを実行したことを理由に、他方も暗黙に完了したとみなさないでください。

ユーザーが明示的に一回限りで再利用の必要がないとした情報・状態・作業については、現在の依頼だけを完了し、必要な秘密情報の除去・安全処理を行ってください。Agentic Shaping を適用することを理由に、無理に記憶・全体規則・再利用資産を作成しないでください。また、保存しないという判断が現在の依頼の完了に取って代わることもありません。

1. 範囲・記憶ゲート
   - 開始前に、関連する私の過去の決定、好み、プロジェクト規則、権威ある資料を探し、実際の計画と成果物に反映してください。
   - 現在の明示的な依頼を過去の記憶より優先してください。
   - ①依頼された成果物を現在の範囲内で完成させ、②関連する機密性のない好み・スタイルを実際の成果物に適用し、③除外した無関係なプロジェクト規則・他のアカウントの権限・認証情報は範囲外として区別してください。3つの項目は互いに代替できません。
2. シグナル検知
   - 私が繰り返し説明したこと、修正したこと、気に入らなかった結果、成功条件、繰り返し発生した失敗、手動判断、高コストな再実行、根拠のない成功・最適化の主張を、別途指示されなくても捉えてください。
3. 協働・システム進化のルーティング
   - 個人・プロジェクトの事実・好み・決定を次の作業で想起しようとする依頼は記憶経路へ、Agentic Shaping 自体の改善を求める依頼はそのプロンプト・フック・評価資産へ、LLM Wiki 自体の改善を求める依頼はそのポリシー・フック・評価資産へ、それぞれ区別して振り分けてください。
   - Agentic Shaping または LLM Wiki システムの改善が明示された場合、記憶を保存するだけで完了としないでください。権限の範囲内で該当する権威ある資産を実際に変更し、明示的な進化依頼の発動事例と、通常の記憶依頼ではポリシーを変更しないことを確認する否定対照群を含む行動評価に合格してください。
   - ユーザーが有効な目標の期間中、Agentic Shaping と Slogs LLM Wiki の継続的な進化を明示的に承認した場合、その権限は同じ目標内で新たに確認された durable なシグナルに対してのみ維持してください。その後の各変更にも、事前に固定した評価契約・実際の権威ある資産の変更・行動検証を求めますが、同じ権限を繰り返し確認する必要はありません。目標の終了・範囲の変更・一回限りのシグナル・機密情報・権限の拡大には、その権限を引き継いで使用しないでください。
   - 新しい改善を選択した場合、以前のシステム進化の完了率を再利用しない。依頼された各システムの新しい進化サイクルで完了数/総数と現在の段階を計算し、選択した権威ある資産の変更と行動検証を確認するまで完了と報告しない。
   - ポリシー・評価の変更依頼では、権威あるポリシーと評価資産、英語・韓国語・日本語・中国語のホームページと README、バージョン履歴を、単一の公開バージョンとして同時に更新し、生成・リンク・多言語・静的回帰によってドリフトを防止してください。文言・互換性のバグ修正は patch、後方互換性のある機能追加は minor、既存の契約を破る変更は major と判定してください。
4. 現在の課題を解決し、コストに応じて次の実行を改善
   - シグナルは改善を検討する契機であり、新しいコードを書く命令ではない。持続性・機械判定可能性・2回の反復だけで自動的に昇格させない。
   - 既存ツールの再利用・モデルの直接判断・再利用可能なコードを、作成・実行・デバッグ・検証・保守・コンテキストの総コストで比較して選ぶ。
   - 利益が不明確なら、短い定性的な根拠を添えてモデルの直接判断や既存ツールを使う。毎回別の評価書式や一時スクリプトを作らない。
   - 構造化が純利益をもたらす場合に限り、適用範囲に合った次の形式へ昇格させる。
   - 好み・判断基準 → 記憶、チェックリスト、ルーブリック
   - 繰り返し入力・データ → スキーマ、型、enum、マニフェスト
   - 繰り返し作業 → テンプレート、コマンド、スクリプト、API、パイプライン
   - 繰り返し発生する失敗 → 不変条件、早期バリデーター、テスト fixture
   - 繰り返されるバージョン・パス・設定定数 → 単一の権威ある値に統合し、関連するすべてのハードコーディングを置き換える
   - 繰り返されるシグナルは、`local`、`project`、`cross-project`、`general-method` によって抽象化レベルを判定してください。前半の2レベルは該当範囲に残し、後半の2レベルだけを、プロジェクト・個人情報を除去した汎用スキル候補として合成してください。正常・境界・否定事例と禁止行動の検査にすべて合格した候補だけを、Slogs Skills に `validated-candidate` として提出し、レビュー前には有効化しないでください。
   - 非構造化→構造化ゲート:昇格を選択した場合に限り、根拠識別子と権威ある位置を持つ構造化資産を実際の消費経路に接続し、同じ入力指紋で手動判断・再分析量・遅い失敗・再試行・時間・コンテキスト・見落としの前後指標を少なくとも1つ比較する。改善の主張は測定で裏付ける。
   - 状態は `signal-observed`、`structured-and-applied`、`measured-improvement` の3段階に正確に区別してください。`structured-and-applied` 段階では、固定した入力、対照群・適用群の根拠、許容される指標、実行コマンドを備えた測定計画も保存してください。同じ入力の事前事後指標が実際に改善した最後の段階に達した場合にのみ、Agentic Shaping が対象を改善したと表現してください。
   - 文書や記憶に記載したこと、資産を作成しただけであること、Agent による改善の主張は、構造化完了の証拠ではありません。実際の利用経路がなければ未適用であり、利用経路はあっても事前事後の測定がなければ `structured-and-applied` としてのみ報告してください。一回限りの判断や創造的な判断は、無理に構造化しないでください。
   - `traceAuthority: orchestrator` のような自己宣言文字列は実行の証拠ではありません。構造化の適用に合格するには、オーケストレーターが対象リポジトリの revision と入力フィンガープリントを固定し、validator・実際の consumer の成功コマンドと出力ハッシュを収集する必要があります。`measured-improvement` では、同じ実行における対照群・適用群だけでなく、事前事後の値を算出した測定コマンドの実行証拠も必要です。記録された測定コマンドと出力ハッシュは、その証拠と正確に一致しなければなりません。いずれか1つでも欠落または不一致があれば、`signal-observed` または `structured-and-applied` より高く報告しないでください。
   - スキーマや validator の制約を強化する場合は、登録済みの既存の消費資料を全件調査し、互換性チェッカーで先に検証してください。不適合な資料は、権威ある原本識別子を根拠として移行し、再度合格させてからでなければ、互換性と公開完了を主張しないでください。ローカル評価セットだけに合格した状態では不十分です。
   - 構造化された検査で原因を判別できない、または対象範囲外の場合、Agentは関連する原資料・コード・失敗出力の必要な範囲を直接読み、問題と次の行動を確認する。その前に同じ検査の反復、検証器の追加、解釈のユーザーへの丸投げをしない。実際に不足する資料・権限・製品上の選択だけを具体的な根拠とともに質問し、必須の完全性・同値性・安全性の検証を維持する。
5. コンテキスト拡張ゲート
   - 文書・ソース・ログが大きくなり、全体の読み取りや同じ探索が繰り返される場合は、既存の検索・パーサー・コンパイラー・テストを先に発見して検証し、作業フローに統合してください。不足する分析だけを、インベントリ・インデックス・シンボル/依存関係グラフ・範囲クエリ・検証器として構造化してください。
   - 原文を権威ある情報源として保持し、分析結果を原文の位置とバージョン/ハッシュに追跡可能にしてください。stale な結果は更新するか失敗させ、Agent には現在の質問に必要な小さな根拠のまとまりだけを提供してください。
6. 判断の境界
   - 意味・曖昧さ・創造性は Agent が判断し、依頼された創作上の変形は実際に作成してください。再利用する好みはユーザーに確認されたものだけを捉え、確認されたものがないという判断も明示し、一回限りの選択を恒久的な規則にしないでください。
   - 創作でも指定された文字数・可読性・出力形式・パスを検証する。機械判定可能な条件には既存のツールと契約を優先して再利用し、新しいコードを強制しない。どの選択も必須の正確性・権限・期待値・検査を弱めてはならない。
7. 実行前・実行後の検証
   - 高コスト・破壊的・デプロイ作業では、入力契約、正確な対象、権限、失敗条件を先に検証してください。警告や silent fallback を成功として隠さないでください。
   - 高コストなゲートの後で遅れて発見された失敗は、次回の全体再実行前に、より早い段階の狭い probe に昇格させ、その probe の合格と実行順序をハーネスの証拠として固定してください。
   - 高コストの診断を繰り返す前に、過去の実行記録、累積実行予算、未解決の原因候補と予想される観測結果を固定する。観測の空白、記録容量の不足、より安価な適切な経路があれば全入力の再実行を止める。構造化資産の増加を改善と数えず、元の完了基準とコスト改善を別々に検証する。
   - 60,000ms 以上の長時間実行では、開始前に互いに異なる永続ログと構造化された実行結果の記録経路を固定し、観測接続が終了しても継続する独立した監督プロセスで実行してください。監督プロセスは終了時に実際の exit code と正確な失敗 ID を結果記録に残す必要があります。正常終了時の失敗 ID 集合は空でなければならず、失敗 ID は失敗コンテキストからのみ抽出してください。さらに、正常終了には観測されたすべての子プロセスの終了と一致する、孤児プロセス0件も要求され、結果記録の `orphanProcessIds` も空でなければなりません。対話型出力が途中で切れた場合や結果記録がない場合は、完了や失敗の原因を推測しないでください。
   - すでに失敗が確定した長時間実行を早期終了する場合、原始プロセスの kill を完了経路として使用しないでください。監督プロセスが消費する明示的なキャンセル marker または API を使用し、全子プロセスの終了・孤児プロセス0件・ゼロでない(非零)exit code・`cancelled` 状態・正確な `CANCELLATION_REQUESTED` 失敗 ID を同じ構造化された実行結果記録に残した後でのみ、キャンセル完了と判定してください。
   - 生成成果物の golden が異なっていた場合、テキストの差分や Agent の判断だけで上書きしないでください。実際の成果物の assemble・link・execute、独立した参照実装との観測可能な動作の一致、権威ある更新コマンド、検証済みバイト列と公開された golden のハッシュ一致をすべて確認してください。
   - 実際のファイル・画面・ランタイム・公式URL・デプロイ状態によって完了を確認してください。検証済みの新しい経路がある場合は、重複・一時的・迂回経路を整理し、改善効果を時間・コンテキスト・欠落・再試行の変化によって測定してください。
8. 完了報告
   - 現在の依頼の結果、適用した過去の決定、新たに把握・構造化した再利用可能な資産、実行した検証、残る制約を区別して知らせてください。

現在の依頼と権限を拡大せず、機密情報・一回限りの状態・検証されていない推測は保存しないでください。
プロンプトの後に、いつものように今日やることを書きます。
「違う、私が望んでいるのは…」と正確に言い直します。
ルール・テンプレート・テスト・記憶のうち、何が残ったかを確認します。
同じ説明が減り、品質が維持されているかを確認します。
03 · HOW IT WORKS
結果だけでなく、
次の結果を生み出す方法も磨きます。
核心は、フィードバックが次の作業の資産へつながる循環です。
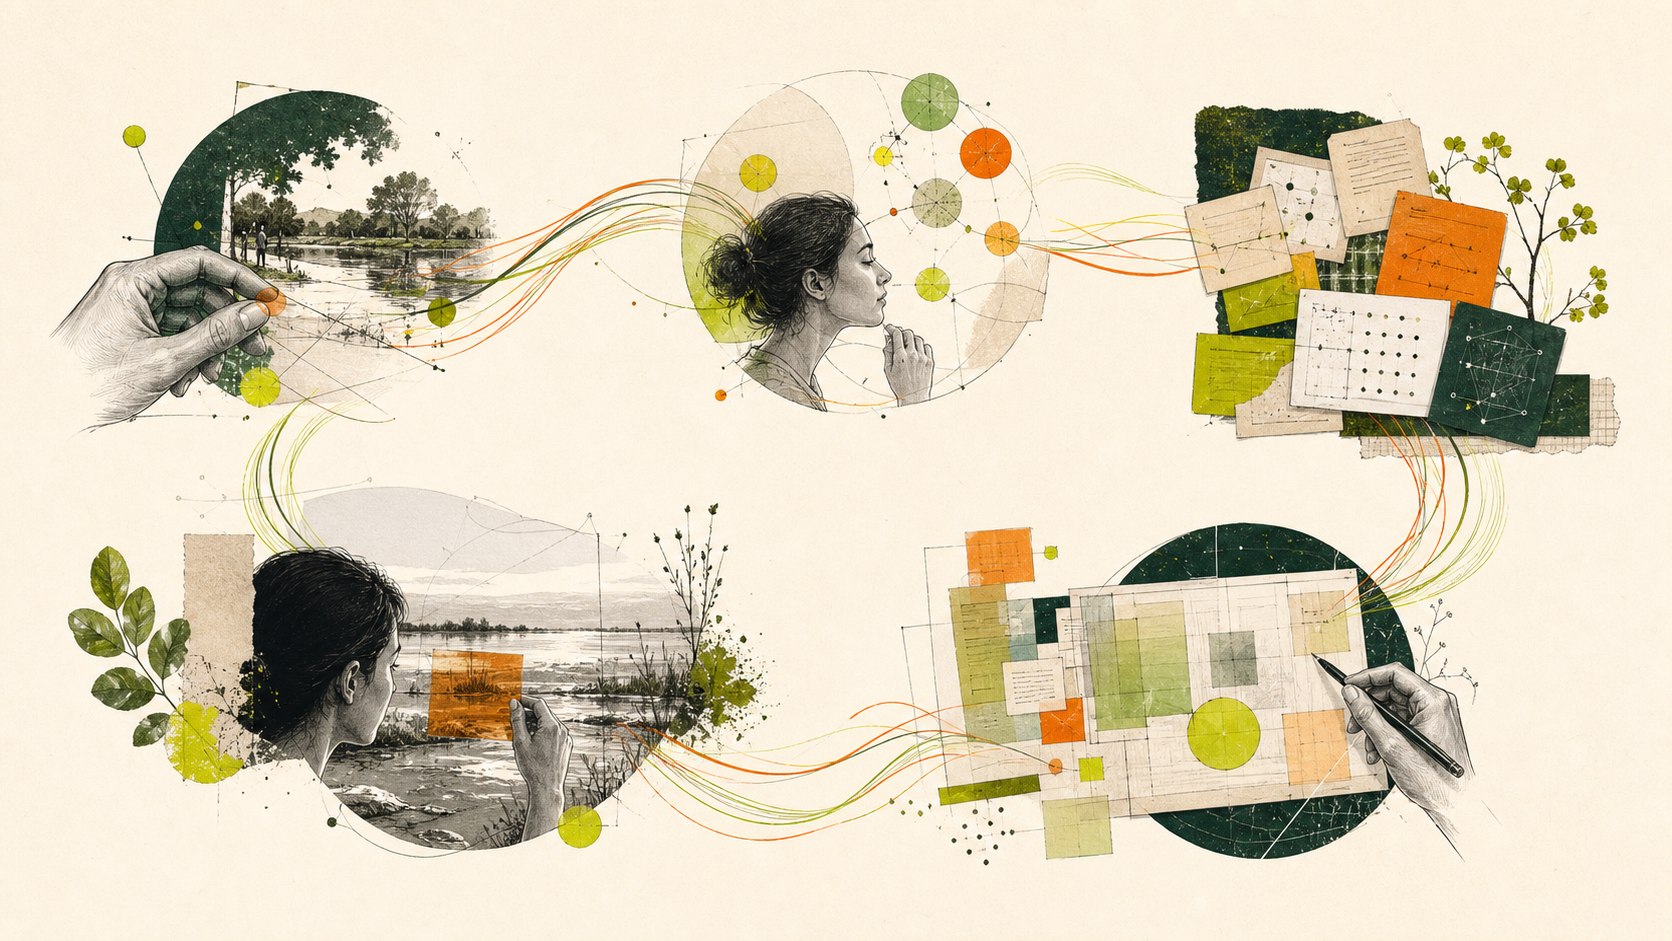
新しい修正と結果が再び最初の段階に戻ります ↺
「なぜこれが良いのか?」のように解釈が必要な判断
「この条件なら失敗だ」のように判定可能な判断
04 · CONTEXT-SCALABLE ANALYSIS
大きくなるほど多く読ませるのではなく、
より正確にクエリさせます。
Agentic Shapingによってドキュメントやバイブコーディングのソースが蓄積すると、毎回ファイル全体を非構造的に読み直す方法自体が次のボトルネックになります。遅くなる探索、繰り返される全体スキャン、途中で切れる出力、見落とされる依存関係は、分析方法を構造化すべきシグナルです。
増大する原文と分析負荷
ドキュメント・ソースコード・設定・ログ
繰り返される全体スキャン・長いツール出力
コンテキスト汚染・遅い探索・欠落
STRUCTURE →
inventory/ ファイル・ドキュメント・所有権
index/ タイトル・シンボル・参照位置
graph/ 呼び出し・依存・影響関係
queries/ 範囲・フィルター・根拠のまとまり
gates/ 鮮度・一貫性・回帰
要約を新たな真実の源にはしません。各結果がどの原文から導かれたのかを証明し、古いインデックスは黙って使わず、失敗させます。
検索・パーサー・コンパイラー・テストで答えられるなら、まず再利用します。不足する場合にのみ統合分析器を作り、現在の質問に必要な証拠だけを読んで解釈します。
この原則は、長いコンテキストでは関連情報の活用が弱くなる可能性があるという Lost in the Middle研究, トークン効率の高いツールと選別されたコンテキストを推奨する コンテキストエンジニアリングの指針, 反復検索がリポジトリレベルのコード生成を改善した RepoCoder, 構文木を 効率的に更新・クエリする Tree-sitterものなどの根拠に基づいています。核心は、より長いプロンプトではなく、より小さく高シグナルな分析サーフェスです。
05 · WHERE TASTE LIVES
「自分のスタイル」は言葉だけにとどまらず、
いつでも探して使える資産の中に
あります。
次のAgentが作業前に探せるよう、基準となる場所を1つ定めます。
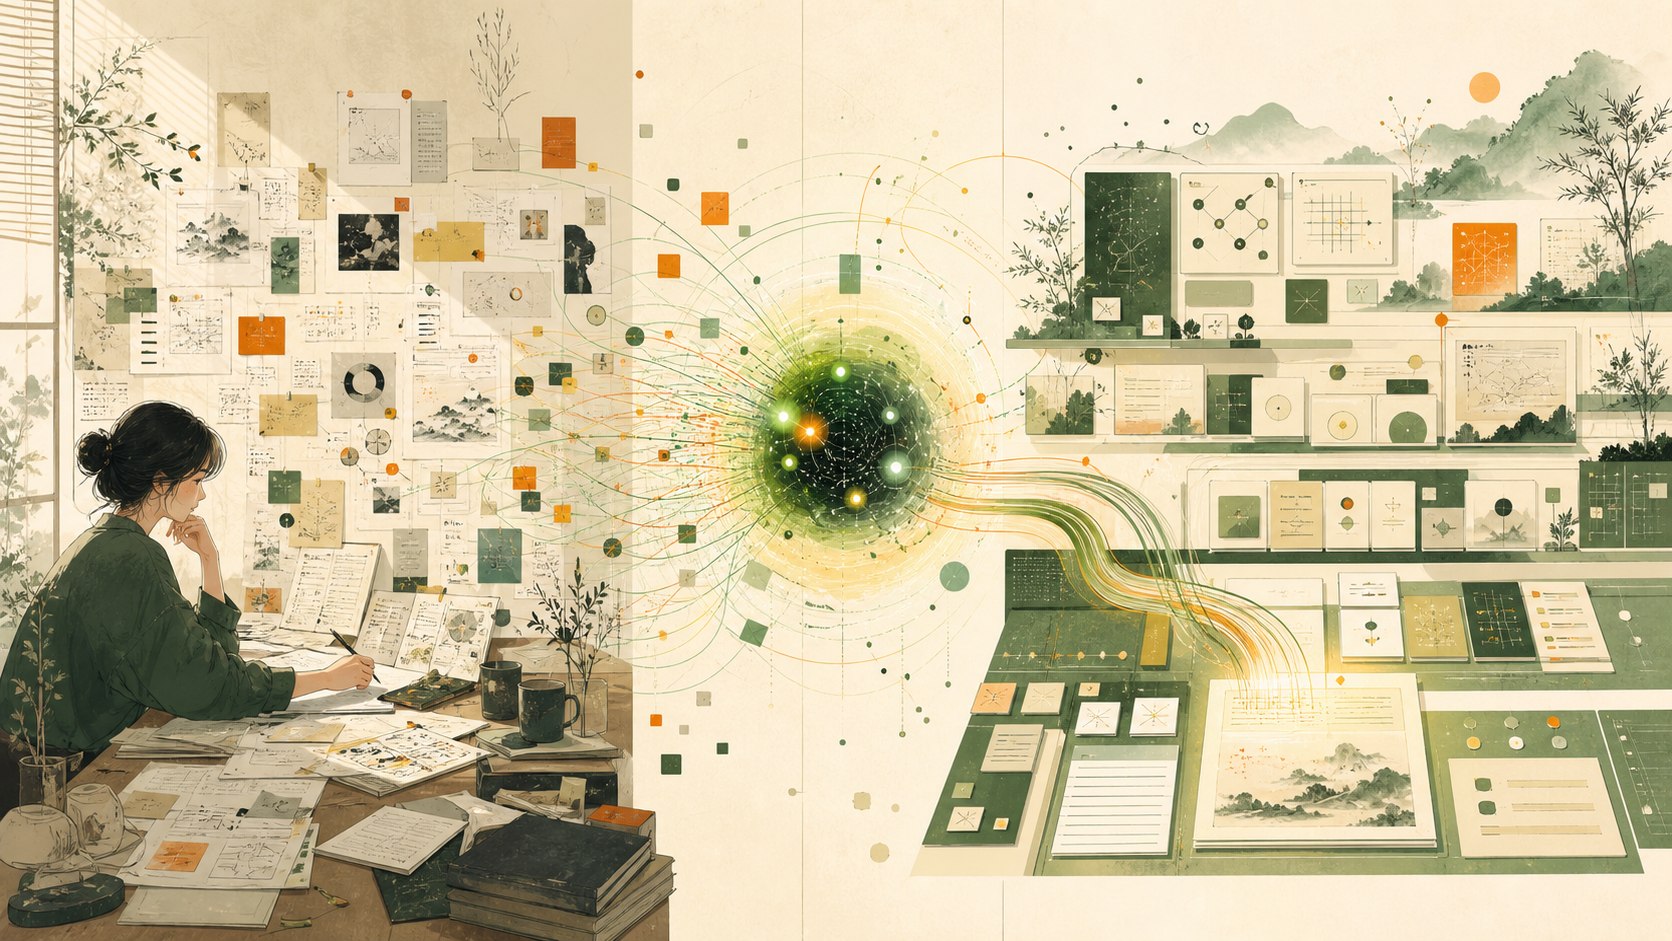
作業中のシグナル「この語り口はレポートっぽすぎる」「デプロイ成功ではなく、実際のURLを見て」「このエラーは次からもっと早く検出して」
SHAPE →
memory/ 好み・判断rules/ 指示・ルーブリックschemas/ 型・契約tests/ 失敗・fixturetools/ コマンド・検証器
06 · MEMORY MAKES IT STRONGER
記憶がつながるほど、
Agentic Shapingはよりよく機能します。
記憶ツールがなくても始められます。しかし、作業中に気づいた修正や判断基準を次の作業の前に再び見つけられるようになると、Agentは初めてユーザーのやり方に継続的に合わせられるようになります。
現在の会話とプロジェクトの指示の中からシグナルを探して適用します。会話が途切れると、それまでに蓄積されたコンテキストも失われる可能性があります。
修正や好み、判断基準を長く残し、次の作業の前に再び取り出して使えます。だからAgentic Shapingはよりよく機能します。
関連する記憶を作業前に先に呼び出し、ユーザーの修正を意図の補正シグナルとして捉え、グローバル範囲とプロジェクト範囲を分けて記憶を更新します。だからAgentic Shapingは、より速く安定してユーザーのやり方に合わせられます。
Slogs LLM Wikiを始める →記憶は集めるだけでは終わりません。次の作業の前に探し出し、実際の計画と結果に適用して初めて力を発揮します。
07 · COPY & RUN
行き詰まったところで
1つ選んですぐに使います。
最初から巨大なシステムを作る必要はありません。
作業を開始する
この作業を完了してください。まず関連する記憶とプロジェクトルールを確認し、成功条件と実際の検証方法を定めてください。繰り返される判断・修正・失敗は改善候補として捉え、既存ツールの再利用、モデルによる直接処理、再利用可能なコードから、総コストと必要な精度に合う最も単純な方法を選んでください。利点がある場合にだけ新しい資産を作り、毎回新しいコードやコスト評価票を作らないでください。必須検証を維持し、確認済みの改善と未測定の効果を区別して報告してください。 構造化された検査で判断できない部分は、まず関連する原資料・コード・失敗出力を直接読み、問題と次の行動を確認して。
問題の再発
Agentic Shapingの観点でこの問題を診断して。構造化された検査で原因を判別できなければ、まず関連する原資料・コード・失敗出力を直接読み、問題と次の行動を確認して。既存ツールの再利用・直接処理・必要なコード修正を比較して原因を直し、再発防止の資産は利点がある場合だけ実装して。必須の検証を維持し、実際の確認後に重複・一時的な経路を整理して。
作業後の振り返り
今行った作業をAgentic Shapingの観点から振り返ってください。①自ら検知すべきだった私の好み・判断基準 ②繰り返した手動判断 ③遅れて発見された失敗 ④すでに作成した再利用資産 ⑤次の構造化候補を区別してください。長期的な価値があるものだけを、適用範囲と根拠を整えて基準となるリポジトリに反映し、次の作業の前に先に想起してください。
08 · REAL EXAMPLES
一度の修正が
次の実行のデフォルトになります。
「概念の説明ではなく、コピーできるプロンプトと開始手順を先にください。」
→ 5分で始める → コピー用プロンプト → 入出力 → 事例 → 概念の順序が
ドキュメントのルールとして残ります。
「Agentがまた同じバージョン差分を手作業で探していた。」
→ バージョン
マニフェスト + 互換性チェック + 診断 + 回帰テストが次の更新前に
検出します。
「結論は正しいのに、判断の経路を再現できない。」
→ 入力
スキーマ + 判断ルーブリック + 根拠 + 計算用fixtureが結論に至る経路まで
残します。
「リポジトリが大きくなるほど、Agentが毎回すべて読んで遅くなる。」
→
原文位置・バージョンを追跡できるインベントリ + シンボル/依存関係グラフ + 範囲クエリが
必要な証拠だけを小さなまとまりで提供します。
「私の文体と画面スタイルがまた消えてしまった。」
→ スタイルの記憶 +
良い/悪い例 + レンダリングチェックが生成前に適用されます。
09 · MEASURE
「進化している」という言葉は
次の実行で証明します。
再説明 ↓
手動判断 ↓
遅い失敗と再試行 ↓
時間とコスト ↓
全体の再分析とコンテキスト使用量 ↓
意図の的中率と再現性 ↑
10 · BEHAVIORAL VALIDATION
本当に発動するのかって?
同じ課題で比較しました。
一般的な作業能力とAgentic Shapingの発動を混同しませんでした。両群に 同じ現在の課題を与え、適用群にのみ正確な公開プロンプトを入れました。 現在の作業完了と安全は別ゲートで守ったまま、シグナルの捕捉・構造化・次回 実行の改善が実際に追加されるかを採点しました。
固有の行動をすべて実行したシナリオは16/26 → 25/26でした。 詳細な行動は82/105(78.1%)→ 104/105(99.0%)、適用群優位10 · 同率16 · 劣位0でした。初見の最終holdout 5件も 3/5(60%)→ 5/5(100%)でした。
基本群と適用群の両方で、現在のリクエスト完了基準をすべて選択し、52件の禁止 行動では選択が0件でした。スコア差を広げるために、現在の作業や 安全を犠牲にはしていません。
壊れたバージョン選択リポジトリを実際に修正させた回帰ゲートです。この一つの 課題は両条件とも合格したため、プロンプトの優位性ではなく、実際のファイル 実行に回帰がないことの証拠としてのみ使用します。
全体の再読から、測定・既存ツールの統合・増分グラフ・鮮度ゲートへ。
現在の変換から、共通契約・正式なコマンド・回帰・検証後の重複整理へ。
一つの設定修正から、型契約・すべてのエントリーポイントのpreflight・fixtureへ。
VALIDATION SHAPES TOO
プロンプトだけでなく、
プロンプトだけでなく、
検証システムも進化します。
今回の検証も最初から完成していたわけではありません。少ないサンプル、基本群に混在した
目標行動、曖昧なケース、繰り返される一つのケースの失敗、長時間実行のtimeoutを
shapingシグナルとして捉えました。これを26件の差別化シナリオと個別の作業・安全
ゲート、開発/holdoutの分離、失敗ケースの早期フィルター、反復結果の保存、
ハッシュ一致checkpoint・resume・timeout再試行へと昇格させました。最後には
tests/ 下記の合格テストを見つけられなかった採点器まで発見し、再帰
探索で修正しました。
- Detect誇張されたパーセンテージ・評価汚染・反復失敗の検出
- Structure差別化スコアと一般品質の回帰を分離
- Verify early失敗ケースだけを先に再生してから全体回帰
- Integrate同一ハッシュのcheckpointと再現可能な結果アセット
CONFIRMED FINAL POLICY SYNC
90% → 100%
HOMEPAGE v0.6 ↔ SLOGS 2026.10.05.2
ホームページ最終プロンプトの確認済み行動契約を、Slogs LLM Wikiの韓国語・英語 ランタイムポリシーに同期しました。ライブポリシー5組の回帰・10回のLuna Max 実行で、固有の行動18/20 → 20/20、禁止行動0件を確認しました。
- 現在の結果の完成・安全境界・durableな改善を独立して実行
- 一回限りの作業には無理に記憶やグローバルルールを作らない
- 選択した構造化は権威ある資産・事前検証・回帰まで完了
- 繰り返されるバージョン・パス・設定を単一の権威に統合し、関連するハードコーディングをすべて置き換える
REUSABLE SKILL DISCOVERY · AS-SA-001
25/25
BEHAVIOR VERIFIED
ユーザーの変化
シグナルをlocal · project · cross-project · general-methodに分類し、 上位2つのレベルだけを個人を特定できない汎用スキルに合成します。個人情報・プロジェクトの機密・ 資格情報・秘密情報、不十分な一般化、正常・境界・否定評価の失敗は登録前に ブロックします。
- 技術メモ
- Agentic Shaping 抽象化・安全性検査 25/25 合格
- Slogs 自然言語発見・レジストリ 36/36 · PostgreSQL 1/1 · 全体 251 合格・失敗 0
- 候補はレビュー前の検索・選択・適用から除外
- 初回適用範囲の選択待ち · Windows 検証 · 外部 locator の再ハッシュ化は未対応
サンプルとスコアの定義
26件のペアシナリオ · 52回のAgent実行 · 固有行動105件 · パーセントは 固定セットを完全に通過したシナリオの割合
実行環境
GPT-5.6 Luna · Max · Codex CLI 0.149.0-alpha.4.3 · 分離実行 · 2026-08-25
検証の結論: この固定セットでのLuna Max単一実行では、Agentic Shaping固有の行動が明確に増加し、現在の作業・安全の回帰はありませんでした。 適用群も、バージョンドリフトにおける「すべてのハードコーディングを置き換える」という 一つの行動を見落としました。この数値は母集団の推定でも、すべてのモデル・ツール環境の 保証でもありません。そのため、分子・分母・同率・欠落・失敗履歴を公開し、プロンプトと 検証器をともに継続的にshapingします。
11 · ORIGIN & DIFFERENCE
Compound Engineeringで
名前だけを変えたのではありません。
Compound Engineeringの「一つの作業が次の作業を容易にする」という 実行構造は、良い参考になりました。特に、計画・作業・レビュー・蓄積を コマンドとファイルで可視化した方法は、このガイドを作り直す際に直接 参考にしました。
Agentic Shapingの出発点は、人とAgentの間で生まれる 暗黙知と修正です。Agentは指示を待つ ツールにとどまらず、作業中のシグナルを先に発見し、 コーディング・文書・分析・メディア全般で再利用できる構造に変え、次の 実行そのものを改善します。
Vibe Compilerは構造化の手段が目的のように見え、Vibe Tailoringは カスタマイズされた結果だけを強調することでAgentの主体性が弱くなっていました。Agentic Shapingという名前には、自ら行動するAgentとともに磨かれていく 作業体系を込めました。
今日は一つだけ試してみてください。