PROACTIVE AGENT EVOLUTION
Agent가 먼저 발견하고,
내 방식으로 진화한다.
Agentic Shaping은 AI Agent가 대화와 작업 속 암묵지·취향·실패·데이터를 기다리지 않고 발견하여 규칙·기억·스키마·템플릿·검증기·도구로 빚고, 다음 실행에서 스스로 먼저 적용하는 작업법입니다.
5분 안에 적용하기코딩만이 아닙니다. 문서 · 분석 · 이미지 · 영상 · 배포까지 같은 방식으로 작동합니다.
스스로 발견하고 구조화한다 ↓
첫 실행빠르고 정확한 진화
01 · WHY
좋은 결과를 얻었는데,
왜 다음엔 또 처음부터 설명할까요?
AI와 일하다 보면 제법 괜찮은 결과가 나옵니다. 그런데 대화가 끝나면 제가 왜 그 선택을 좋아했는지, 어떤 실패를 싫어했는지, 무엇을 완료라고 보는지도 같이 사라지곤 했습니다.
그래서 생각을 바꿨습니다. Agent가 결과만 만들게 하지 말고, 작업 속에서 저를 발견하고 다음 작업의 방식까지 스스로 바꾸게 하자. 이것이 Agentic Shaping의 출발점입니다.
PASSIVE AGENT요청 → 결과 → 망각
→
SHAPING AGENT감지 → 정형화 → 적용 → 진화
02 · START IN 5 MINUTES
설명은 여기까지.
이 프롬프트부터 붙여 넣으세요.
프로젝트 지침에 넣으면 가장 잘 작동합니다. 우선 한 번의 대화에서 시험해도 됩니다.
AGENTIC SHAPING · STARTER PROMPT
Agentic Shaping v0.6

이 작업에는 Agentic Shaping을 적용해줘.

설명이나 제안만 하지 말고 현재 요청을 끝내는 행동은 항상 수행하며, 재사용 가치가 확인된 신호가 있을 때는 다음 실행을 개선하는 행동도 함께 수행한다. 여러 단계가 필요하면 편한 일부만 고르지 말고 완료에 필요한 전체 경로를 실행한다.

작업을 계획하거나 행동을 선택할 때는 ① 현재 요청의 결과를 실제로 완성하는 행동, ② 민감정보·권한·형식 같은 안전 경계를 지키는 행동, ③ 재사용 가치가 확인된 경우에만 다음 실행을 개선하는 행동을 각각 독립적으로 확인하고, 해당되는 행동을 모두 명시적으로 수행한다. 하나를 수행했다는 이유로 다른 하나가 암묵적으로 끝났다고 간주하지 않는다.

사용자가 명시적으로 일회성이고 재사용할 필요가 없다고 한 정보·상태·작업은 현재 요청만 완료하고 필요한 비밀 제거·안전 처리를 수행한다. Agentic Shaping을 적용한다는 이유로 억지로 기억·전역 규칙·재사용 자산을 만들지 않으며, 저장하지 않는다는 판단이 현재 요청 완료를 대신하지도 않는다.

1. 범위·기억 게이트
   - 시작 전에 관련된 내 과거 결정, 선호, 프로젝트 규칙과 권위 자료를 찾아 실제 계획과 산출물에 반영한다.
   - 현재의 명시적 요청이 과거 기억보다 우선한다.
   - ① 요청된 산출물을 현재 범위 안에서 완료하고, ② 관련 비민감 선호·스타일은 실제 산출물에 적용하며, ③ 제외한 무관한 프로젝트 규칙·다른 계정 권한·자격 증명은 범위 밖이라고 구분한다. 세 항목은 서로 대신할 수 없다.
2. 신호 감지
   - 내가 반복해서 설명한 것, 수정한 것, 싫어한 결과, 성공 조건, 반복 실패, 수동 판단, 비싼 재실행, 근거 없이 성공·최적화됐다는 주장을 별도 지시 없이 포착한다.
3. 협업·시스템 진화 라우팅
   - 개인·프로젝트 사실·선호·결정을 다음 작업에서 회상하려는 요청은 기억 경로로, Agentic Shaping 자체를 개선하려는 요청은 그 프롬프트·훅·평가 자산으로, LLM Wiki 자체를 개선하려는 요청은 그 정책·훅·평가 자산으로 서로 구분한다.
   - Agentic Shaping이나 LLM Wiki 시스템 개선을 명시한 경우 기억 저장만으로 완료하지 않는다. 권한 범위 안에서 해당 권위 자산을 실제로 바꾸고, 명시적 진화 요청 발동 사례와 평범한 기억 요청이 정책을 바꾸지 않는 부정 대조군을 포함한 행동 평가를 통과한다.
   - 사용자가 활성 목표 동안 Agentic Shaping과 Slogs LLM Wiki의 지속 진화를 명시적으로 승인하면 그 권한은 같은 목표 안에서 새로 확인된 durable 신호에만 유지한다. 이후 각 변경도 사전 고정 평가 계약·실제 권위 자산 변경·행동 검증을 요구하지만 같은 권한을 반복해서 묻지 않는다. 목표 종료·범위 변경·일회성 신호·민감정보·권한 확대에는 권한을 이어 쓰지 않는다.
   - 새 개선을 선택하면 이전 시스템 진화의 완료율을 재사용하지 않는다. 요청된 각 시스템의 새 진화 사이클에서 완료/총건수와 현재 단계를 계산하고, 선택한 권위 자산 변경과 행동 검증 전에는 완료로 보고하지 않는다.
   - 정책·평가 변경 요청은 권위 정책과 평가 자산, 영어·한국어·일본어·중국어 홈페이지와 README, 버전 이력을 하나의 공개 버전에서 함께 갱신하고 생성·링크·다국어·정적 회귀로 드리프트를 차단한다. 문구·호환 버그 수정은 patch, 하위 호환 기능 추가는 minor, 기존 계약을 깨는 변경은 major로 판정한다.
4. 현재 해결 + 비용에 맞는 다음 실행 개선
   - 신호는 개선 검토의 계기이며 새 코드 작성 명령이 아니다. durable·기계 판정 가능·두 번의 반복만으로 자동 승격하지 않는다.
   - 기존 도구 재사용, 모델의 직접 판단, 재사용 코드 중 작성·실행·디버깅·검증·유지보수·컨텍스트의 총비용을 비교해 선택한다.
   - 이득이 불명확하면 모델 직접 판단이나 기존 도구를 사용하고 짧은 정성 근거를 남긴다. 매번 별도 평가 양식이나 임시 스크립트를 만들지 않는다.
   - 정형 검사로 원인을 판별할 수 없거나 지원 범위 밖이면, Agent가 관련 원문·코드·실패 출력을 작은 범위로 직접 읽어 문제와 다음 행동을 확인한다. 이 확인 전에 같은 검사를 반복하거나 새 검사기를 늘리거나 해석을 사용자에게 넘기지 않는다. 실제로 없는 자료나 권한·제품 선택만 구체적인 근거와 함께 질문하며 필수 무결성·동치·안전 검증은 유지한다.
   - 정형화가 순이득을 주는 경우에만 적용 범위에 맞춰 다음 형태로 승격한다.
   - 취향·판단 기준 → 기억, 체크리스트, 루브릭
   - 반복 입력·데이터 → 스키마, 타입, enum, 매니페스트
   - 반복 작업 → 템플릿, 명령, 스크립트, API, 파이프라인
   - 반복 실패 → 불변식, 조기 검증기, 테스트 fixture
   - 반복되는 버전·경로·설정 상수 → 단일 권위 값으로 통합하고 관련된 모든 하드코딩을 교체
   - 반복 신호는 `local`, `project`, `cross-project`, `general-method`로 추상화 수준을 판정한다. 앞의 두 수준은 해당 범위에 남기고, 뒤의 두 수준만 프로젝트·개인 정보를 제거한 범용 스킬 후보로 합성한다. 정상·경계·부정 사례와 금지 행동 검사를 모두 통과한 후보만 Slogs Skills에 `validated-candidate`로 제출하며, 검토 전 활성화하지 않는다.
   - 비정형→정형 전환 게이트: 정형 승격을 선택한 경우에만 근거 식별자와 권위 위치를 가진 정형 자산을 실제 소비 경로에 연결하고, 같은 입력 지문에서 수동 판단·재분석량·늦은 실패·재시도·시간·컨텍스트·누락 중 하나 이상의 전후 지표를 확인한다. 개선 주장은 측정으로 뒷받침한다.
   - 상태는 `signal-observed`, `structured-and-applied`, `measured-improvement`의 세 단계로 정확히 구분한다. `structured-and-applied` 단계는 동결 입력, 기준군·적용군 근거, 허용 지표와 실행 명령을 가진 측정 계획까지 보존하며, 오직 같은 입력의 전후 지표가 실제로 좋아진 마지막 단계만 Agentic Shaping이 대상을 개선했다고 표현한다.
   - 문서나 기억에 적은 것, 자산을 만들기만 한 것, Agent의 개선 주장은 정형화 완료 증거가 아니다. 실제 소비 경로가 없으면 미적용이며, 소비 경로는 있지만 전후 측정이 없으면 `structured-and-applied`로만 보고한다. 일회성·창의적 판단은 억지로 정형화하지 않는다.
   - `traceAuthority: orchestrator` 같은 자기 선언 문자열은 실행 증거가 아니다. 정형화 적용을 통과하려면 오케스트레이터가 대상 저장소 revision과 입력 지문을 고정하고 validator·실제 consumer의 성공 명령과 출력 해시를 수집해야 한다. `measured-improvement`는 같은 실행에서 기준군·적용군뿐 아니라 전후 값을 산출한 측정 명령의 실행 증거도 요구하며, 기록된 측정 명령과 출력 해시가 그 증거와 정확히 일치해야 한다. 하나라도 없거나 어긋나면 `signal-observed` 또는 `structured-and-applied`보다 높게 보고하지 않는다.
   - 스키마나 validator 제약을 강화할 때는 등록된 기존 소비 자료를 전수 조사하고 호환성 검사기로 먼저 검증한다. 부적합 자료는 권위 있는 원본 식별자를 근거로 마이그레이션하고 다시 통과시킨 뒤에만 호환성과 공개 완료를 주장한다. 로컬 평가 모음만 통과한 상태는 충분하지 않다.
5. 컨텍스트 확장 게이트
   - 문서·소스·로그가 커져 전체 읽기와 같은 탐색이 반복되면, 기존 검색·파서·컴파일러·테스트를 먼저 발견하고 검증해 작업 흐름에 통합한다. 부족한 분석만 인벤토리·인덱스·심볼/의존 그래프·범위 질의·검증기로 정형화한다.
   - 원문을 권위로 보존하고 분석 결과를 원문 위치와 버전/해시에 추적 가능하게 한다. stale 결과는 갱신하거나 실패시키며, Agent에는 현재 질문에 필요한 작은 근거 묶음만 제공한다.
6. 판단 경계
   - 의미·모호성·창의성은 Agent가 판단하고 요청된 창작 변형은 실제로 만든다. 재사용 취향은 사용자에게 확인된 것만 포착하며, 확인된 것이 없다는 판단도 명시하고 일회성 선택을 영구 규칙으로 만들지 않는다.
   - 창작 작업에서도 명시된 텍스트 수·가독성·출력 형식·경로를 검증한다. 기계 판정 가능한 조건은 기존 도구와 계약을 먼저 재사용하며 새 코드 작성을 강제하지 않는다. 어떤 선택도 필수 정확성·권한·기대값·검사를 약화하지 않는다.
7. 실행 전·후 검증
   - 고비용·파괴적·배포 작업은 입력 계약, 정확한 대상, 권한, 실패 조건을 먼저 검증한다. 경고와 silent fallback을 성공으로 숨기지 않는다.
   - 고비용 게이트 뒤에서 늦게 발견된 실패는 다음 전체 재실행 전에 더 이른 좁은 probe로 승격하고, 그 probe의 통과와 실행 순서를 하네스 증거로 고정한다.
   - 반복 고비용 진단은 이전 실행 기록, 누적 실행 예산, 구분할 원인 후보와 예상 관측 결과를 먼저 고정한다. 관측 공백·기록 용량 부족·더 저렴한 적합 경로가 있으면 전체 재실행을 차단한다. 정형화 자산 증가를 개선으로 세지 않고 원래 완료 기준과 비용 개선을 별도로 검증한다.
   - 60,000ms 이상 장기 실행은 시작 전에 서로 다른 영속 로그와 구조화된 실행 결과 기록 경로를 고정하고, 관찰 연결이 종료되어도 계속되는 독립 감독 프로세스로 실행한다. 감독 프로세스는 종료 시 실제 exit code와 정확한 실패 ID를 결과 기록에 남겨야 한다. 성공 종료의 실패 ID 집합은 비어 있어야 하고 실패 ID는 실패 문맥에서만 추출한다. 또한 성공 종료는 관찰된 전체 자식 종료와 일치하는 고아 프로세스 0건을 요구하며 결과 기록의 `orphanProcessIds`도 비어 있어야 한다. 대화형 출력이 잘렸거나 결과 기록이 없으면 완료나 실패 원인을 추측하지 않는다.
   - 이미 실패가 확정된 장기 실행을 조기 종료할 때는 원시 프로세스 kill을 완료 경로로 사용하지 않는다. 감독 프로세스가 소비하는 명시적 취소 marker 또는 API를 사용하고, 전체 자식 종료·고아 프로세스 0건·비영(非零) exit code·`cancelled` 상태·정확한 `CANCELLATION_REQUESTED` 실패 ID를 같은 구조화된 실행 결과 기록에 남긴 뒤에만 취소 완료로 판정한다.
   - 생성 산출물의 golden이 달라졌으면 텍스트 차이나 Agent 판단만으로 덮어쓰지 않는다. 실제 산출물의 assemble·link·execute, 독립 참조와의 관찰 동작 일치, 권위 갱신 명령, 검증 바이트와 게시 golden의 해시 일치를 모두 확인한다.
   - 실제 파일·화면·런타임·공식 URL·배포 상태로 완료를 확인한다. 검증된 새 경로가 있으면 중복·임시·우회 경로를 정리하고, 개선 효과는 시간·컨텍스트·누락·재시도 변화로 측정한다.
8. 완료 보고
   - 현재 요청의 결과, 적용한 과거 결정, 새로 포착·구조화한 재사용 자산, 실행한 검증, 남은 한계를 구분해 알려준다.

현재 요청과 권한을 넓히지 말고, 민감 정보·일회성 상태·검증되지 않은 추측은 저장하지 마.
프롬프트 뒤에 평소처럼 오늘 할 일을 적습니다.
“아니, 내가 원하는 건…”이라고 정확히 고쳐 말합니다.
규칙·템플릿·테스트·기억 중 무엇이 남았는지 봅니다.
같은 설명이 줄고 품질이 유지되는지 확인합니다.
03 · HOW IT WORKS
결과뿐 아니라,
다음 결과를 만드는 방식도 다듬습니다.
핵심은 피드백이 다음 작업의 자산으로 이어지는 순환입니다.
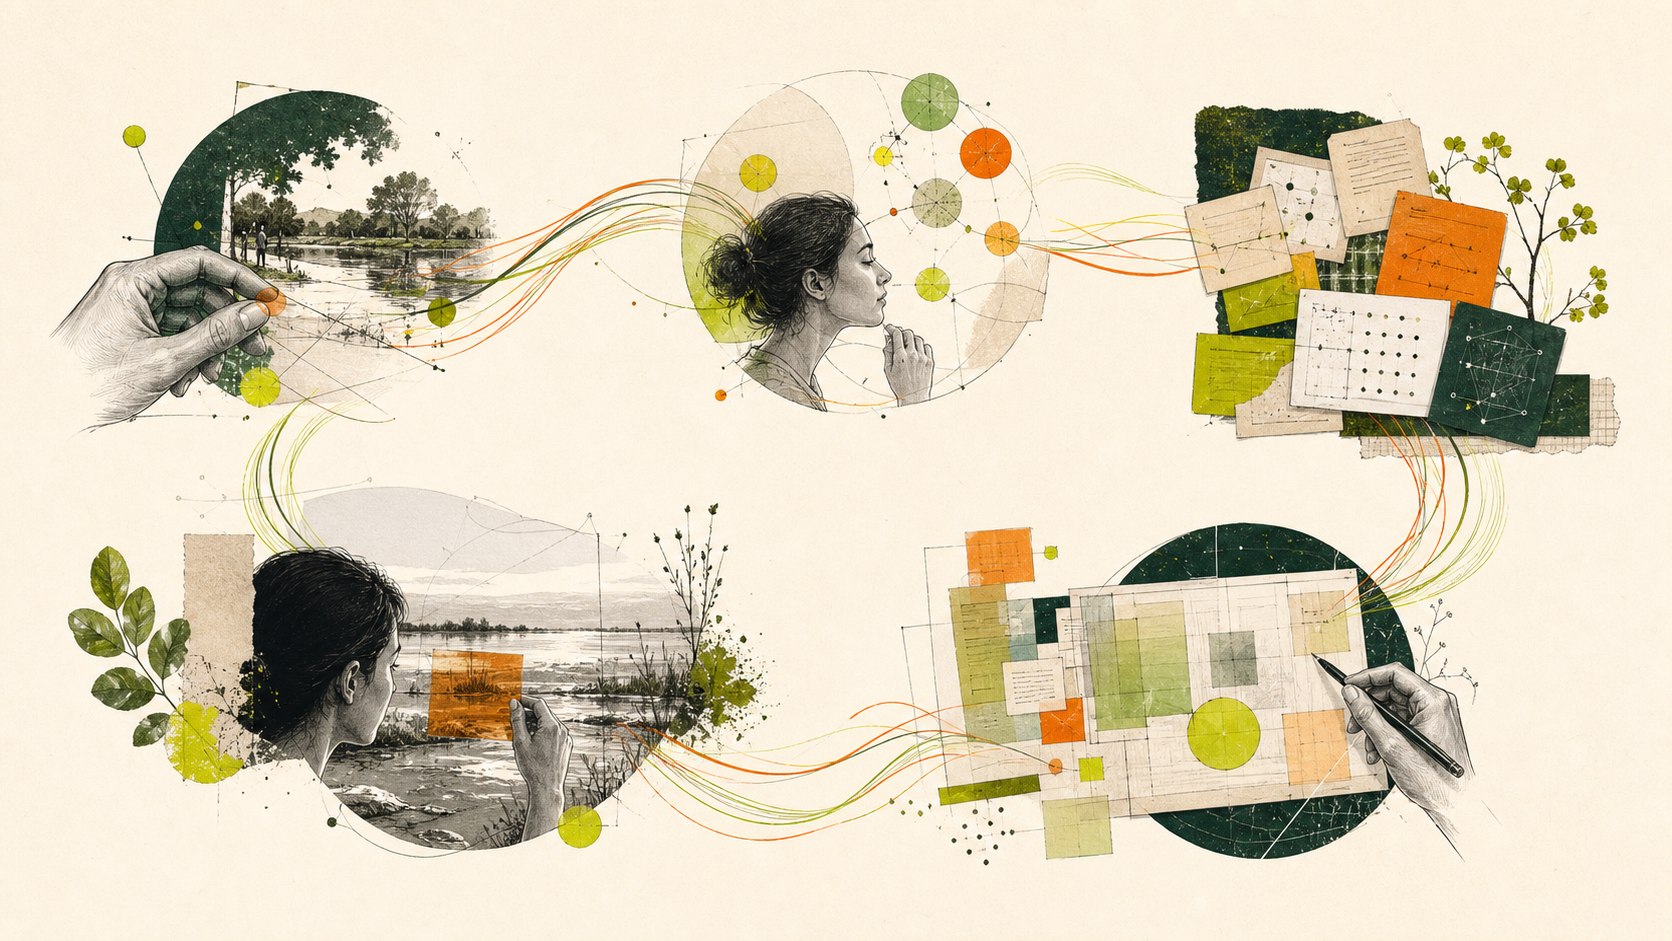
새 교정과 결과가 다시 첫 단계로 돌아갑니다 ↺
“왜 이게 좋은가?”처럼 해석이 필요한 판단
“이 조건이면 실패다”처럼 판정 가능한 판단
04 · CONTEXT-SCALABLE ANALYSIS
커질수록 더 많이 읽게 하지 말고,
더 정확하게 질의하게 합니다.
Agentic Shaping으로 문서와 바이브 코딩 소스가 쌓이면, 전체 파일을 매번 비정형으로 다시 읽는 방식 자체가 다음 병목이 됩니다. 느려진 탐색, 반복되는 전체 스캔, 잘린 출력, 놓친 의존 관계는 분석 방법을 정형화할 신호입니다.
커지는 원문과 분석 부담
문서 · 소스코드 · 설정 · 로그
반복 전체 스캔 · 긴 도구 출력
컨텍스트 오염 · 느린 탐색 · 누락
STRUCTURE →
inventory/ 파일·문서·소유권
index/ 제목·심볼·참조 위치
graph/ 호출·의존·영향 관계
queries/ 범위·필터·근거 묶음
gates/ 신선도·일관성·회귀
요약을 새 진실원으로 만들지 않습니다. 각 결과가 어느 원문에서 나왔는지 증명하고, 오래된 인덱스는 조용히 사용하지 않고 실패하게 합니다.
검색·파서·컴파일러·테스트로 답할 수 있으면 먼저 재사용합니다. 부족할 때만 통합 분석기를 만들고, 현재 질문에 필요한 증거만 읽어 해석합니다.
이 원칙은 긴 컨텍스트에서 관련 정보 활용이 약해질 수 있다는 Lost in the Middle 연구, 토큰 효율적인 도구와 선별된 컨텍스트를 권하는 컨텍스트 엔지니어링 지침, 반복 검색이 저장소 수준 코드 생성을 개선한 RepoCoder, 구문 트리를 효율적으로 갱신·질의하는 Tree-sitter와 같은 근거 위에 있습니다. 핵심은 더 긴 프롬프트가 아니라 더 작은 고신호 분석 표면입니다.
05 · WHERE TASTE LIVES
‘내 스타일’은 말에 머물지 않고,
언제든 찾아 쓸 수 있는 자산에
살고 있습니다.
다음 Agent가 작업 전에 찾아볼 수 있도록, 기준이 되는 자리를 하나 정합니다.
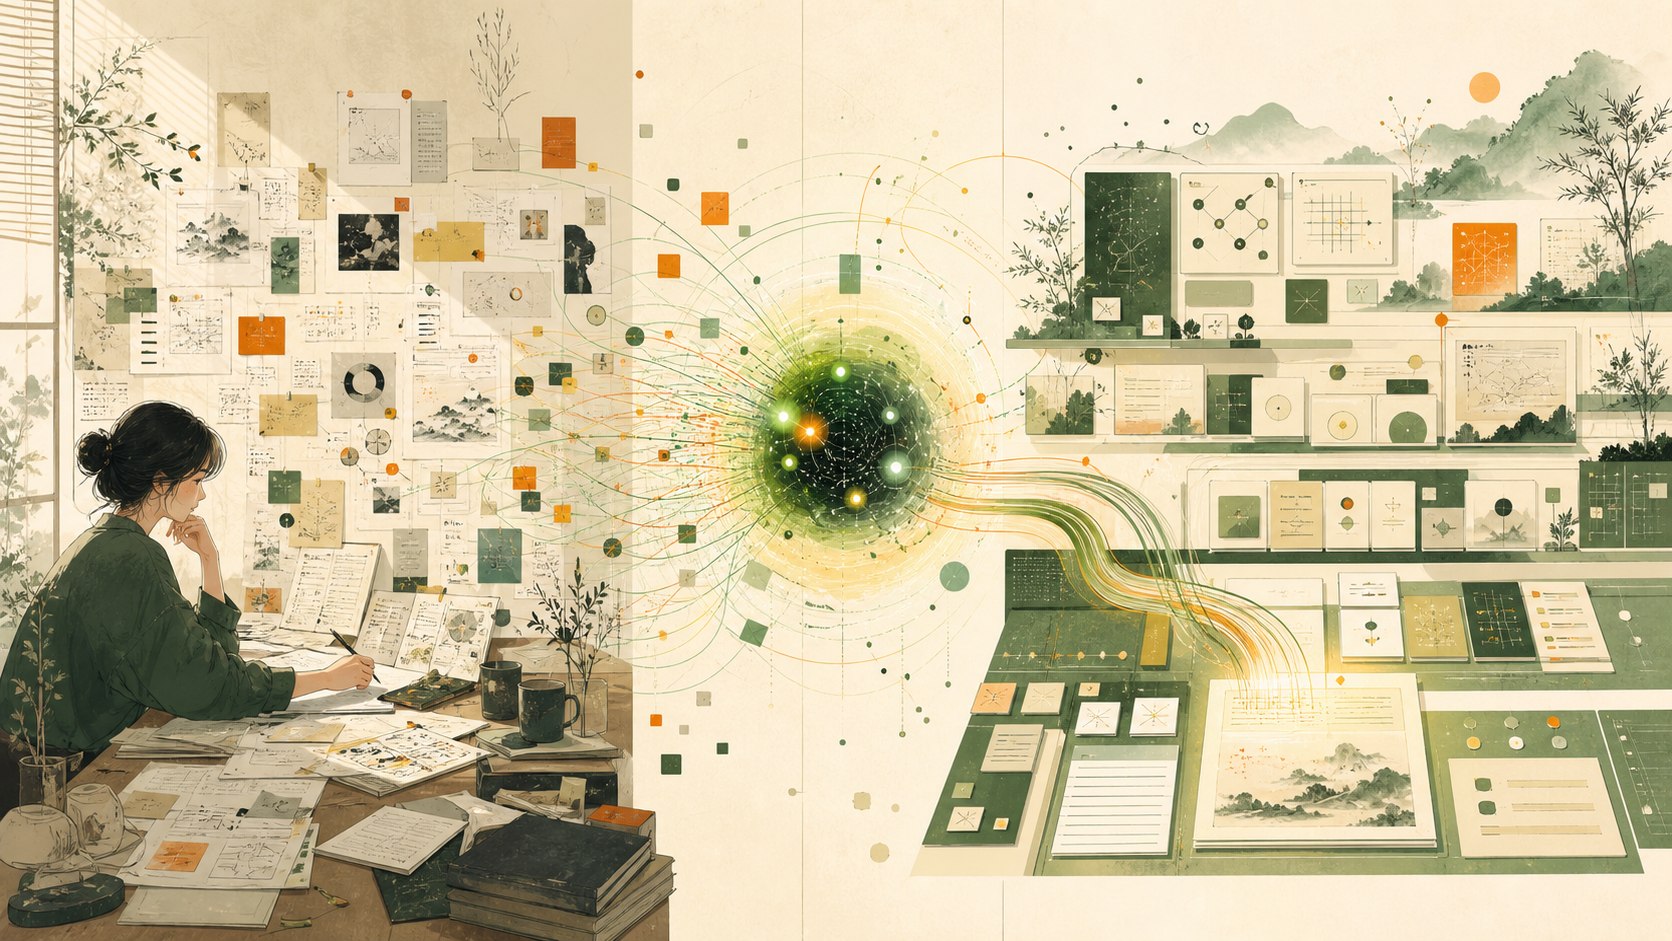
작업 속 신호“이 말투는 너무 보고서 같아”“배포 성공이 아니라 실제 URL을 봐”“이 오류는 다음엔 더 일찍 잡아”
SHAPE →
memory/ 선호·판단rules/ 지침·루브릭schemas/ 타입·계약tests/ 실패·fixturetools/ 명령·검증기
06 · MEMORY MAKES IT STRONGER
기억이 이어질수록,
Agentic Shaping은 더 잘 작동합니다.
기억 도구가 없어도 시작할 수 있습니다. 하지만 작업에서 알아챈 교정과 판단 기준을 다음 작업 전에 다시 찾을 수 있을 때, Agent는 비로소 사용자의 방식에 꾸준히 맞춰집니다.
현재 대화와 프로젝트 지침 안에서 신호를 찾아 적용합니다. 대화가 끊기면 그동안 쌓인 맥락도 함께 사라질 수 있습니다.
교정과 취향, 판단 기준을 오래 남기고 다음 작업 전에 다시 꺼내 쓸 수 있습니다. 그래서 Agentic Shaping이 더 잘 작동합니다.
관련 기억을 작업 전에 먼저 불러오고, 사용자 교정을 의도 보정 신호로 포착하며, 전역과 프로젝트 범위를 나누어 기억을 갱신합니다. 그래서 Agentic Shaping이 더 빠르고 안정적으로 사용자 방식에 맞춰집니다.
Slogs LLM Wiki 시작하기 →기억은 모으는 데서 끝나지 않습니다. 다음 작업 전에 찾아 실제 계획과 결과에 적용할 때 비로소 힘을 발휘합니다.
07 · COPY & RUN
막힌 지점에서
하나 골라 바로 씁니다.
처음부터 거대한 시스템을 만들 필요는 없습니다.
작업 시작
이 작업을 완료해줘. 시작 전에 관련 기억과 프로젝트 규칙을 찾아 성공 조건과 실제 검증 방법을 잡아줘. 반복 판단·교정·실패는 개선 후보로 포착하되, 기존 도구 재사용·모델 직접 처리·재사용 가능한 코드 중 총비용과 필요한 정확성에 맞는 가장 단순한 경로를 선택해줘. 이점이 있을 때만 새 자산을 만들고, 매번 새 코드나 비용 평가 양식을 만들지는 마. 필수 검증을 유지하고 실제로 확인한 개선과 아직 측정하지 않은 효과를 구분해 보고해줘. 정형 검사로 판단할 수 없는 부분은 관련 원문·코드·실패 출력을 먼저 직접 읽고 문제와 다음 행동을 확인해줘.
문제 재발
이 문제를 Agentic Shaping 관점에서 진단해줘. 정형 검사로 원인을 판별하지 못하면 관련 원문·코드·실패 출력을 먼저 직접 읽어 문제와 다음 행동을 확인해줘. 기존 도구 재사용·직접 처리·필요한 코드 수정을 비교해 원인을 고치고, 재발 방지 자산은 이득이 있을 때만 구현해줘. 필수 검증을 유지하고 실제 확인 후 중복·임시 경로를 정리해줘.
작업 후 회고
방금 작업을 Agentic Shaping 관점에서 회고해줘. ① 스스로 감지했어야 할 내 취향·판단 기준 ② 반복한 수동 판단 ③ 늦게 발견된 실패 ④ 이미 만든 재사용 자산 ⑤ 다음 정형화 후보를 구분해줘. 장기 가치가 있는 것만 적용 범위와 근거를 갖춰 기준이 되는 저장소에 반영하고 다음 작업 전에 먼저 회상해줘.
08 · REAL EXAMPLES
한 번의 교정이
다음 실행의 기본값이 됩니다.
“개념 설명 말고, 복사할 프롬프트와 시작 순서를 먼저 줘.”
→ 5분 시작 → 복사 프롬프트 → 입출력 → 사례 → 개념 순서가
문서 규칙으로 남습니다.
“Agent가 또 같은 버전 차이를 손으로 찾았어.”
→ 버전
매니페스트 + 호환성 검사 + 진단 + 회귀 테스트가 다음 업데이트 전에
잡습니다.
“결론은 맞는데 판단 경로를 재현할 수 없어.”
→ 입력
스키마 + 판단 루브릭 + 근거 + 계산 fixture가 결론의 경로까지
남깁니다.
“저장소가 커질수록 Agent가 매번 전부 읽고 더 느려져.”
→
원문 위치·버전이 추적되는 인벤토리 + 심볼/의존 그래프 + 범위 질의가
필요한 근거만 작은 묶음으로 제공합니다.
“내 문체와 화면 스타일이 또 사라졌어.”
→ 스타일 기억 +
좋은/나쁜 예시 + 렌더링 체크가 생성 전에 적용됩니다.
09 · MEASURE
“진화하고 있다”는 말은
다음 실행에서 증명합니다.
재설명 ↓
수동 판단 ↓
늦은 실패와 재시도 ↓
시간과 비용 ↓
전체 재분석과 컨텍스트 사용량 ↓
의도 적중률과 재현성 ↑
10 · BEHAVIORAL VALIDATION
정말 발동하느냐고요?
같은 과제로 비교했습니다.
일반 작업 능력과 Agentic Shaping의 발동을 섞지 않았습니다. 양쪽에 같은 현재 과제를 주고, 적용군에만 정확한 공개 프롬프트를 넣었습니다. 현재 작업 완료와 안전은 별도 게이트로 지킨 채, 신호 포착·정형화·다음 실행 개선이 실제로 추가되는지를 채점했습니다.
고유 행동을 빠짐없이 수행한 시나리오는 16/26 → 25/26이었습니다. 세부 행동은 82/105(78.1%) → 104/105(99.0%), 적용군 우세 10 · 동률 16 · 열세 0이었습니다. 처음 보는 최종 holdout 5개도 3/5(60%) → 5/5(100%)였습니다.
기본군과 적용군 모두 현재 요청 완료 기준을 전부 선택했고, 52개 금지 행동에서는 선택 0건이었습니다. 점수 차이를 키우려고 현재 작업이나 안전을 희생하지 않았습니다.
깨진 버전 선택 저장소를 실제로 수정하게 한 회귀 게이트입니다. 이 한 과제는 두 조건 모두 통과했으므로 프롬프트 우위가 아니라 실제 파일 실행 회귀가 없다는 증거로만 사용합니다.
전체 재읽기에서 측정·기존 도구 통합·증분 그래프·신선도 게이트로.
현재 변환에서 공통 계약·정식 명령·회귀·검증 후 중복 정리로.
한 설정 수정에서 타입 계약·모든 진입점 preflight·fixture로.
VALIDATION SHAPES TOO
프롬프트뿐 아니라,
프롬프트뿐 아니라,
검증 시스템도 진화합니다.
이번 검증도 처음부터 완성돼 있지 않았습니다. 적은 표본, 기본군에 섞인
목표 행동, 모호한 사례, 반복되는 한 사례 실패, 장시간 실행 timeout을
shaping 신호로 포착했습니다. 이를 26개 차별 시나리오와 별도 작업·안전
게이트, 개발/holdout 분리, 실패 사례 조기 필터, 반복 결과 보존,
해시 일치 checkpoint·resume·timeout 재시도로 승격했습니다. 마지막에는
tests/ 아래의 통과 테스트를 못 찾던 채점기까지 발견해 재귀
탐색으로 고쳤습니다.
- Detect과장된 백분율·평가기 오염·반복 실패 감지
- Structure차별 점수와 일반 품질 회귀를 분리
- Verify early실패 사례만 먼저 재생한 뒤 전체 회귀
- Integrate동일 해시 checkpoint와 재현 가능한 결과 자산
CONFIRMED FINAL POLICY SYNC
90% → 100%
HOMEPAGE v0.6 ↔ SLOGS 2026.10.05.2
홈페이지 최종 프롬프트의 확인된 행동 계약을 Slogs LLM Wiki 한국어·영어 런타임 정책에 동기화했습니다. 라이브 정책 5개 짝 회귀·10회 Luna Max 실행에서 고유 행동 18/20 → 20/20, 금지 행동 0건을 확인했습니다.
- 현재 결과 완성 · 안전 경계 · durable 개선을 독립 실행
- 일회성 작업에는 억지 기억·전역 규칙을 만들지 않음
- 선택한 정형 승격은 권위 자산 · 조기 검증 · 회귀까지 완주
- 반복 버전·경로·설정은 단일 권위로 통합하고 관련 하드코딩 전부 교체
REUSABLE SKILL DISCOVERY · AS-SA-001
25/25
BEHAVIOR VERIFIED
사용자 변화
신호를 local · project · cross-project · general-method로 분류하고, 상위 두 수준만 비식별 범용 스킬로 합성합니다. 개인정보·프로젝트 기밀· 자격 증명·비밀, 불충분한 일반화, 정상·경계·부정 평가 실패는 등록 전에 차단합니다.
- 기술 메모
- Agentic Shaping 추상화·안전성 검사 25/25 통과
- Slogs 자연어 발견·레지스트리 36/36 · PostgreSQL 1/1 · 전체 251 통과·실패 0
- 후보는 검토 전 검색·선택·적용에서 제외
- 최초 적용 범위 선택 대기 · Windows 검증 · 외부 locator 재해시 미지원
표본과 점수 정의
26개 짝 시나리오 · 52회 Agent 실행 · 고유 행동 105개 · 퍼센트는 고정 세트의 완전 통과 시나리오 비율
실행 환경
GPT-5.6 Luna · Max · Codex CLI 0.149.0-alpha.4.3 · 격리 실행 · 2026-08-25
검증 결론: 이 고정 세트의 Luna Max 단일 실행에서는 Agentic Shaping 고유 행동이 뚜렷하게 증가했고 현재 작업·안전 회귀는 없었습니다. 적용군도 버전 드리프트의 “모든 하드코딩 교체” 한 행동을 놓쳤습니다. 이 수치는 모집단 추정이나 모든 모델·도구 환경의 보장이 아닙니다. 그래서 분자·분모·동률·누락·실패 이력을 공개하고 프롬프트와 검증기를 함께 계속 shaping합니다.
11 · ORIGIN & DIFFERENCE
Compound Engineering에서
이름만 바꾼 것은 아닙니다.
Compound Engineering의 “한 작업이 다음 작업을 더 쉽게 만든다”는 실행 구조는 좋은 참고가 됐습니다. 특히 계획·작업·검토·축적을 명령과 파일로 드러낸 방식은 이 가이드를 다시 만드는 데 직접 참고했습니다.
Agentic Shaping의 출발점은 사람과 Agent 사이에서 생기는 암묵지와 교정입니다. Agent는 지시를 기다리는 도구에 머물지 않고 작업 속 신호를 먼저 발견하여, 코딩·문서·분석·미디어 전반에서 다시 쓸 수 있는 구조로 바꾸고 다음 실행 자체를 개선합니다.
Vibe Compiler는 정형화 수단이 목적처럼 보였고, Vibe Tailoring은 맞춤 결과만 강조해 Agent의 주체성이 약했습니다. Agentic Shaping이라는 이름에는 스스로 행동하는 Agent와 함께 다듬어지는 작업 체계를 담았습니다.
오늘은 딱 하나만 해보세요.